miércoles, 28 de enero de 2026

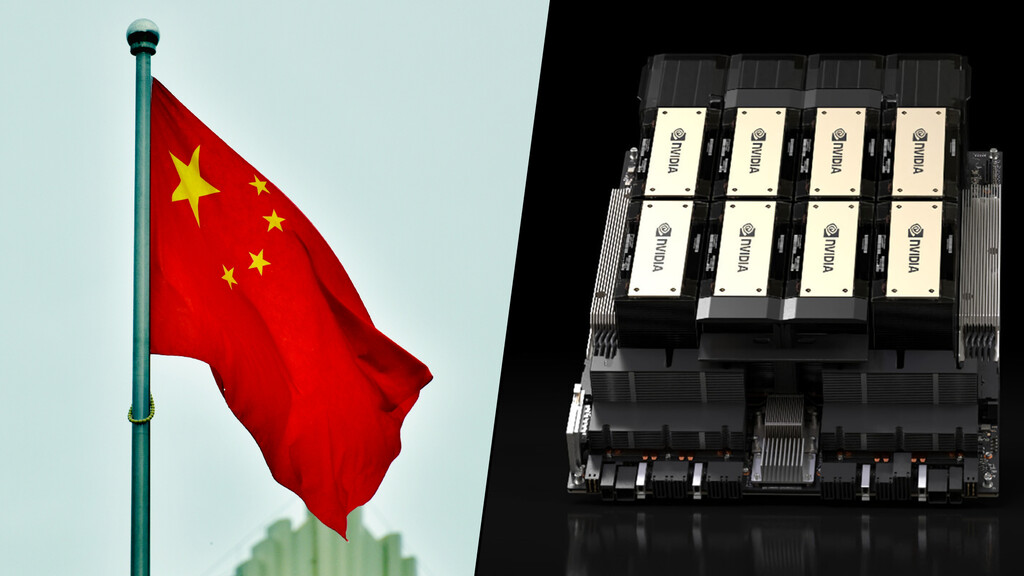
NVIDIA ha conseguido algo que parecía imposible: que China apruebe la compra de sus chips H200

NVIDIA ha conseguido algo que parecía imposible: que China apruebe la compra de sus chips H200

China ha dado luz verde por primera vez a la compra de los chips H200 de NVIDIA destinados a IA, lo que ha permitido que varias de las principales compañías tecnológicas del país puedan importar estos semiconductores. Llevábamos unas semanas esperando a que Pekín se pronunciara al respecto, ya que NVIDIA se encontraba multiplicando su producción de chips para estar preparada para este momento. Aunque hay algunas reglas que las empresas deben cumplir.

La decisión. Según cuenta el medio Reuters, ByteDance, Alibaba y Tencent han recibido autorización para adquirir más de 400.000 chips H200 en total, una operación valorada en aproximadamente 10.000 millones de dólares. Se espera que más empresas chinas reciban el visto bueno en las próximas semanas, aunque aún no se han detallado condiciones específicas.

De visita. La autorización se produce durante la visita de Jensen Huang, CEO de NVIDIA, a China esta semana. Huang ha recorrido Shanghái, Pekín y Shenzhen en lo que es su tradicional viaje anual antes de las celebraciones del Año Nuevo Lunar. Sin embargo, según cuenta el Wall Street Journal, no se ha reunido con altos funcionarios chinos.
Por qué es importante. La aprobación rompe un punto muerto que ha durado meses. En abril, Estados Unidos prohibió inicialmente la venta de chips H20 a China, una versión menos potente que NVIDIA había diseñado específicamente para el mercado chino. Aunque Washington dio marcha atrás con los H20, Pekín entonces indicó a las empresas a no comprarlos, alegando problemas de ciberseguridad que NVIDIA negó. 

Tras una reunión entre Trump y Xi Jinping en Corea del Sur el pasado mes de octubre, Estados Unidos autorizó la exportación del H200, un chip significativamente más potente. Ahora, China cumple su parte aprobando la importación de estos chips al país.

El dilema de Pekín. El tema es que China se estaba preparando para un mundo completamente independiente de tecnología estadounidense, por lo que tras la aprobación baila en un delicado equilibrio. Por un lado, Pekín quiere que sus mejores desarrolladores de IA puedan construir nuevos modelos y aplicaciones rápidamente, algo que los chips de NVIDIA facilitarían enormemente. Por otro, lleva años cultivando una industria de semiconductores autosuficiente. Aunque según cuenta WSJ, el país ha encontrado resistencia especialmente en empresas del sector privado acostumbradas a usar productos y herramientas de software de NVIDIA.

Las condiciones del acuerdo. Según Reuters, las aprobaciones incluyen restricciones que aún se están definiendo. Pero lo que sí se sabe es que las empresas chinas que desean comprar los chips estadounidenses han tenido que presentar documentos a las autoridades explicando cómo planean utilizarlos. Las autoridades del país han indicado que cualquier compra debe ser para usos considerados necesarios, como investigación y desarrollo avanzado en IA, según informa WSJ. 

Algunas empresas han incluido en sus acuerdos además planes para adquirir chips fabricados en China, ya que las autoridades exigen que las compañías usen semiconductores de producción local para algunas tareas de entrenamiento de IA y la mayoría de cargas de trabajo relacionadas con inferencia.
Brecha tecnológica. El H200 representa un salto cualitativo significativo, ya que supera en aproximadamente seis veces el rendimiento del H20. Aunque empresas chinas como Huawei ahora tienen productos que rivalizan con el rendimiento del H20, todavía están muy por detrás del H200. Y es que para no quedarse atrás en la carrera de la IA, las grandes tecnológicas chinas se han puesto a la cola para pedir más de dos millones de chips H200, superando con creces el inventario disponible de NVIDIA.

Impacto. NVIDIA había visto su cuota de chips de IA en el mercado chino caer del 95% a prácticamente cero mientras esperaba las acciones de ambos gobiernos, según declaraba Huang en octubre. Mientras tanto, las compañías chinas han intentado llenar ese vacío utilizando una gran cantidad de chips de menor potencia para conseguir aumentar la capacidad de procesamiento.

Y ahora qué. Según cuenta WSJ, Huang tiene previsto viajar próximamente a Taiwán, también parte de su rutina anual, donde se espera que hable con proveedores sobre la fabricación de más chips H200 para alimentar la demanda en China. Tras la tregua comercial de octubre entre EEUU y China, parece que las aguas se han calmado, al menos desde lo superficial.

Imagen de portada | Arthur Wang y NVIDIA

En Xataka | Meta, Google y TikTok han condenado a toda una generación al "doomscrolling". Y ahora van a ser juzgadas por ello


via Robótica e IA - Xataka https://ift.tt/DqrcdTU

martes, 27 de enero de 2026

Microsoft quiere reducir su dependencia con NVIDIA y que sus centros de datos no sean un agujero de dinero: su solución es Maia 200

Microsoft quiere reducir su dependencia con NVIDIA y que sus centros de datos no sean un agujero de dinero: su solución es Maia 200

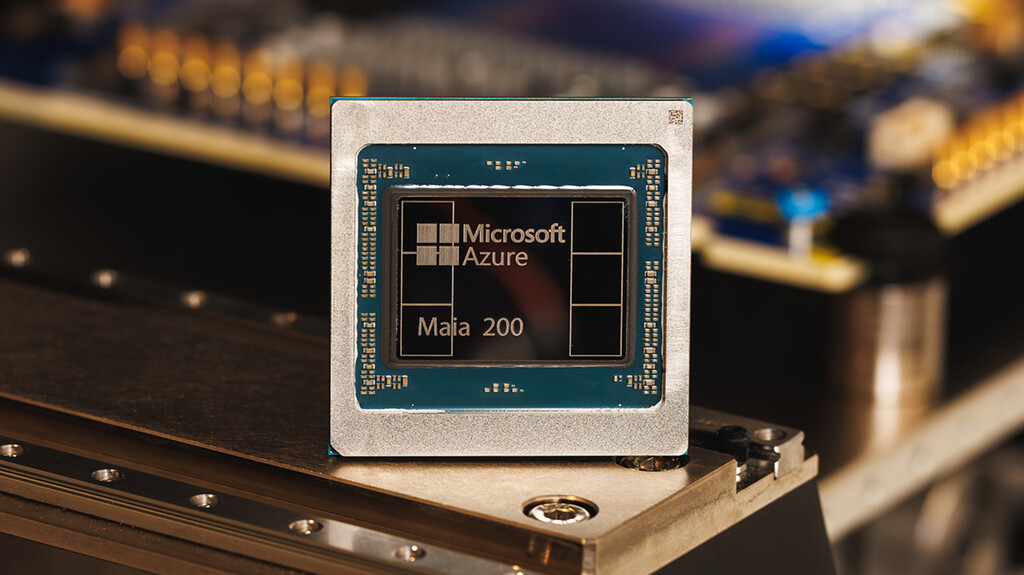
Microsoft ha presentado el Maia 200, su segundo acelerador de IA de diseño propio orientado a la inferencia de modelos, es decir, a ejecutarlos una vez entrenados. El chip, fabricado en proceso de 3 nanómetros de TSMC, busca mejorar la eficiencia y reducir los costes operativos de los centros de datos y el resto de servicios dependientes de la IA de la compañía. Bajo estas líneas te contamos todos los detalles.

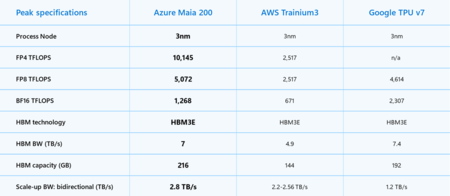
Qué hace especial a este chip. Según cuenta la compañía, el Maia 200 integra más de 140.000 millones de transistores y está optimizado para trabajar con modelos de lenguaje de gran tamaño. Microsoft promete un 30% más de rendimiento por dólar que la generación anterior, el Maia 100. La compañía afirma además que supera en rendimiento FP4 al Trainium3 de Amazon y al TPU de séptima generación de Google en precisión FP8.

Microsoft Microsoft Imagen: Microsoft

Por qué importa la inferencia. La inferencia es el proceso de ejecutar un modelo ya entrenado para generar respuestas, y comienza a ser un gasto cada vez más importante para las empresas de IA. A diferencia del entrenamiento de modelos, que requiere potencia bruta de cálculo durante períodos concentrados, la inferencia es un proceso que debe funcionar de manera continua y eficiente para no comprometer la experiencia de millones de usuarios.

Características técnicas destacadas. El chip incorpora 216 GB de memoria HBM3e con un ancho de banda de 7 TB/s y 272 MB de SRAM integrada. Según la compañía, el chip puede alcanzar más de 10 petaflops en precisión de 4 bits (FP4) y aproximadamente 5 petaflops en 8 bits (FP8), todo ello con un consumo de 750W. Tal y como ha compartido Microsoft, también han diseñado un sistema de memoria jerárquico que promete distribuir las cargas de trabajo de manera más inteligente entre la SRAM y la HBM para mantener los modelos alimentados con datos en todo momento.

Dónde y para qué se usará. Microsoft ya ha comenzado a desplegar el Maia 200 en su centro de datos de Azure US Central, cerca de Des Moines (Iowa), con la región US West 3 en Phoenix como siguiente destino. El chip se utilizará para ejecutar modelos como GPT-5.2 de OpenAI en servicios como Microsoft 365 Copilot y Microsoft Foundry. El equipo de Superinteligencia de Microsoft también lo empleará para generar datos sintéticos y tareas de aprendizaje por refuerzo.

Menor dependencia. Con el Maia 200, Microsoft se suma a una tendencia creciente entre las grandes tecnológicas: diseñar sus propios aceleradores para reducir la dependencia de NVIDIA, cuyos chips dominan el mercado y tienen un coste elevado. Google dispone de sus TPU, Amazon tiene Trainium, y ahora Microsoft refuerza su hardware con este segundo chip tras el Maia 100 lanzado en 2023. Según las especificaciones, el Maia 200 funciona a casi la mitad del consumo energético que el NVIDIA Blackwell B300 Ultra (750W frente a 1400W), aunque los dos chips están diseñados para casos de uso diferentes (inferencia vs. entrenamiento + inferencia).

Entre líneas. El lanzamiento del Maia 200 llega realmente con retraso. Según apuntan desde Tom's Hardware, el chip conocido internamente como Braga, estaba previsto para 2025 y podría haber salido antes que el B300 de NVIDIA. El mensaje de Microsoft insiste repetidamente en la eficiencia y el rendimiento por dólar, por lo que se alinea con la estrategia de la compañía de mantener a raya los costes operativos de la IA todo lo posible. También coincide con las recientes declaraciones de Satya Nadella, CEO de Microsoft, sobre la necesidad de que la industria mantenga el "permiso social" para seguir expandiendo sus centros de datos.

Y ahora qué. Microsoft ya está trabajando en futuras generaciones del Maia y, según comparte el medio Tom's Hardware, el próximo chip podría fabricarse con el proceso 18A de Intel Foundry. Mientras tanto, el despliegue del Maia 200 permitirá a la compañía probar su capacidad para competir con Amazon y Google en infraestructura propia, mientras contiene los costes operativos de ejecutar sus servicios de IA a gran escala.

Imagen de portada | Microsoft

En Xataka | La cantidad de nuevas aplicaciones que llegan a la App Store se ha disparado. Tenemos un culpable: el "vibe coding"


via Robótica e IA - Xataka https://ift.tt/s3yukfP

Samsung va a empezar a fabricar memoria HBM4 en febrero con una misión clara: romper el monopolio de SK Hynix en IA

Samsung va a empezar a fabricar memoria HBM4 en febrero con una misión clara: romper el monopolio de SK Hynix en IA

Samsung Electronics va a empezar en febrero, de forma inminente, la fabricación de memorias HBM4, la siguiente generación de chips de alta velocidad que alimentan los aceleradores de IA. Ya ha superado las pruebas de cualificación tanto de NVIDIA como de AMD, según fuentes de la industria citadas por Reuters y Korea Economic Daily.

Las primeras entregas irán a NVIDIA para su plataforma Vera Rubin, cuyo CEO, Jensen Huang, ha confirmado que ya está en producción con un lanzamiento previsto para la segunda mitad de 2026.

Por qué es importante. Este movimiento está llamado a cambiar el equilibrio de poder en el mercado de memoria para IA, donde SK Hynix ha sido el proveedor dominante de NVIDIA. La demanda de chips HBM se ha disparado con el auge de la IA generativa, y eso los ha convertido en uno de los cuellos de botella más críticos de la industria tecnológica.

  • Para NVIDIA, diversificar el suministro reduce el riesgo de depender de un solo proveedor cuando la demanda de sus aceleradores supera por mucho su capacidad.
  • Para Samsung, recuperar terreno significa acceder a unos ingresos por valor de decenas de miles de millones anuales en un momento crítico: necesita este impulso porque precisamente SK Hynix ha erosionado una parte de su negocio.

Entre líneas. Samsung ha jugado una carta arriesgada: adoptar un proceso de fabricación de DRAM de 10 nanómetros de sexta generación (1c) antes que nadie, a pesar de sufrir rendimientos iniciales muy bajos. También ha integrado un chip lógico de 4 nanómetros, más avanzado que el de SK Hynix.

La apuesta está dando frutos: los chips HBM4 de Samsung alcanzaron velocidades de 10,7 gigabits por segundo en las pruebas de NVIDIA, superando el umbral de los 10 Gbps. SK Hynix registró 8,3 Gbps y Micron alrededor de 8 Gbps, según una fuente técnica citada por Korea Herald.

  • El cambio en los criterios de cualificación ha favorecido a Samsung. Nvidia y AMD han endurecido los requisitos de velocidad pero han relajado los límites térmicos porque priorizan el rendimiento bruto.
  • Esto ocurre después de que aceleradores como los TPU de Google hayan demostrado un rendimiento comparable a las GPU de NVIDIA.

Sí, pero. SK Hynix ya está manos a la obra para evitar perder terreno: ha rediseñado sus chips HBM4 y espera los resultados de nuevas calificaciones que le dejen en ventaja. En febrero empezará a desplegar obleas en su nueva planta M15X en Cheongju para producir chips HBM.

Además, SK Hynix cerró en octubre todos los acuerdos de suministro HBM con sus mayores clientes para 2026. Samsung llega después, intentando arañar la cuota que pueda, gracias a que todos los fabricantes operan al límite de su capacidad.

El trasfondo geopolítico. Corea del Sur concentra más del 70% de la producción mundial de chips HBM, un componente tan crítico para la IA que determina quién puede entrenar los modelos más avanzados y quién no.

China, pese a sus descomunales inversiones en semiconductores, sigue unos años por detrás en esta tecnología por las restricciones occidentales sobre equipos de litografía avanzada. El dominio surcoreano en HBM es una de las ventajas más valiosas que mantiene el bloque tecnológico occidental.

Y ahora qué. Ambas empresas tienen que publicar este jueves sus resultados trimestrales. Y es de esperar que aprovechen para dar más detalles sobre los pedidos de HBM4 y la demanda real. Esos números dirán mucho sobre quién está ganando esta batalla por el componente más valioso de la era de la IA.

En Xataka | Hay una víctima inesperada de la escalada de precios de las memorias RAM: los modernísimos coches conectados

Imagen destacada | Samsung


via Robótica e IA - Xataka https://ift.tt/eSFd6X2

lunes, 26 de enero de 2026

Qwen3-Max-Thinking rivaliza más que nunca con Gemini 3 Pro de Google. La clave está en lo que no se está contando

Qwen3-Max-Thinking rivaliza más que nunca con Gemini 3 Pro de Google. La clave está en lo que no se está contando

Hay días en los que da la sensación de que abrimos el móvil y el tablero vuelve a cambiar. Desde que ChatGPT irrumpió en noviembre de 2022, la carrera de la inteligencia artificial no ha dejado de acelerarse, y cada pocas semanas aparece un nuevo modelo que promete empujar un poco más el listón. A veces es una actualización, otras es un “flagship” con un apellido distinto, pero el patrón se repite: más potencia, más ambición y un relato cada vez más global. En ese contexto, China está ganando visibilidad de forma cada vez más evidente, y el nombre que ahora se cuela en la conversación es Qwen3-Max-Thinking, la propuesta de Alibaba con la que quiere jugar en la misma liga que las grandes referencias del momento.

A primera vista, Qwen3-Max-Thinking podría parecer otro nombre más en la lista interminable de modelos. Pero aquí hay un matiz relevante: lo presenta como su modelo estrella para tareas de razonamiento, y lo coloca explícitamente en la misma conversación que Gemini 3 Pro. La compañía asegura que ha escalado parámetros y ha invertido recursos de computación en refuerzo para mejorar varias dimensiones a la vez, desde conocimiento factual y razonamiento complejo hasta seguimiento de instrucciones, alineamiento con preferencias humanas y capacidades de agente. Dicho de otro modo: no está vendiendo solo potencia bruta, sino una forma de “pensar” mejor.

Lo que los benchmarks enseñan

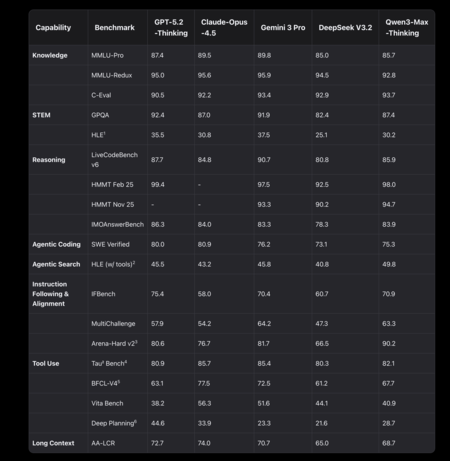
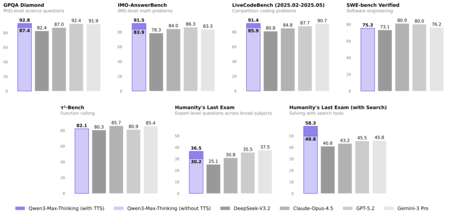
Para aterrizar esa promesa, lo más útil es mirar la tabla comparativa que tenemos entre manos, con 19 benchmarks y un recuento directo: Gemini 3 Pro lidera en 11, Qwen3-Max-Thinking lo hace en 8. Este dato, por sí solo, no decide “quién es mejor”, pero sí ayuda a entender el tipo de pulso que plantea Alibaba cuando lo enfrenta a Google. Aquí merece la pena ser muy literal con lo que estamos midiendo: cada benchmark se centra en una habilidad concreta, desde conocimiento general hasta programación, uso de herramientas, seguimiento de instrucciones o análisis de contexto largo.

Tabla Rendimiento Modelos Tabla Rendimiento Modelos

Si buscamos el punto donde Qwen3-Max-Thinking aprieta de verdad, hay uno que destaca por encima del resto: el seguimiento de instrucciones y la alineación con lo que los humanos prefieren en una conversación. En Arena-Hard v2, Qwen se impone con 90,2 frente a 81,7 de Gemini, que es la mayor diferencia a su favor en toda la tabla (8,5 puntos arriba). No es un matiz menor, porque este tipo de benchmark no premia solo el “acierto” técnico, sino el resultado final que una persona considera más útil al comparar respuestas a ciegas. A eso se suma IFBench, donde Qwen gana por la mínima (70,9 frente a 70,4). Traducido a la vida real: cuando el usuario no formula una instrucción perfecta, cuando el encargo tiene ambigüedad o exige interpretar intención, Qwen parece más orientado a clavar lo que se le pide y a hacerlo de una forma que se siente natural.

Score Score

El otro terreno donde Qwen sostiene su narrativa de “modelo pensante” es el razonamiento matemático y la resolución lógica de problemas. En HMMT, tanto en la edición de noviembre de 2025 como en la de febrero de 2025, Qwen queda por delante (94,7 frente a 93,3 y 98,0 frente a 97,5, respectivamente). Y en IMOAnswerBench también gana, aunque por un margen mínimo: 83,9 frente a 83,3. Estos números no sugieren una paliza, pero sí un patrón consistente: cuando el problema exige varios pasos de lógica y no se resuelve solo con memoria o con una respuesta bonita, Qwen tiende a sacar ventaja.

A estas mejoras Alibaba les añade un componente que ya se está convirtiendo en el nuevo estándar: que el modelo no se quede en el texto, sino que pueda actuar. En su presentación, la compañía habla de un uso adaptativo de herramientas que permite recuperar información bajo demanda e invocar un intérprete de código. Y en los benchmarks también aparece esa orientación: en HLE (w/ tools), Qwen se impone con 49,8 frente a 45,8 de Gemini, lo que sugiere una mejor capacidad para desenvolverse cuando el modelo puede apoyarse en herramientas externas. Aquí el cambio de fondo es importante: ya no es solo “qué responde”, sino cómo investiga, cómo decide qué herramienta utilizar y cómo sintetiza lo que encuentra.

Hay una parte de esta comparación donde Gemini 3 Pro se siente más “ingeniero” que “conversador”, y es precisamente donde muchos usuarios profesionales ponen el foco. El modelo de Google gana en MMLU-Pro y MMLU-Redux, dos pruebas muy asociadas a conocimiento general, y también en GPQA y HLE, que en esta tabla aparecen como benchmarks exigentes de evaluación y preguntas complejas. En código, Gemini se impone en LiveCodeBench v6 y también en SWE Verified, lo que refuerza la idea de que, para tareas de programación, sigue siendo una apuesta muy sólida. A eso se suma AA-LCR, donde lidera en análisis de documentos largos.

La letra pequeña se esconde más allá del precio

Llegados a este punto, hay una pregunta que pesa tanto como cualquier benchmark: cuánto cuesta usar estos modelos en serio. En precios estándar por 1M de tokens, el contraste es claro. En Gemini 3 Pro, la entrada se mueve entre 2 y 4 dólares según el tramo de tokens de entrada, mientras que en Qwen3-Max el input figura en 1,2 dólares. Pero la diferencia más importante aparece en la salida, que es donde se paga el “pensamiento” del modelo: Gemini marca 12 a 18 dólares frente a los 6 dólares de Qwen. Traducido en proporciones, en uso estándar Gemini es aproximadamente 1,67 veces más caro en entrada y 2 veces en salida en el tramo habitual. Si el tramo supera los 200.000 tokens de entrada, la distancia sube a 3,33 veces en entrada y 3 veces en salida.

Gemini es aproximadamente 1,67 veces más caro en entrada y 2 veces en salida en el tramo habitual.

Y aquí llegamos a la parte que suele quedar fuera de la conversación cuando todo se centra en potencia y precio: qué pasa con tus datos cuando usas el modelo, y bajo qué reglas. En el caso de Qwen, hay que separar claramente dos mundos. Por un lado está el chat web de consumo, cuyos términos contemplan el uso y almacenamiento del “contenido de Usuario” para desarrollar y mejorar tecnologías de IA, incluyendo contenido desidentificado, y la posibilidad de procesarlo para nuevos productos y servicios. Además, al menos en nuestra revisión, no hemos encontrado un control claro o una opción visible que permita desactivar ese uso. Por otra parte, en el material revisado no aparece una referencia explícita a la UE ni al RGPD. En su política de privacidad, Alibaba advierte de transferencias internacionales de datos y señala que el servicio se presta generalmente desde Singapur y que los datos suelen procesarse en Singapur, Indonesia y o China.

Alibaba, eso sí, introduce matices importantes. El entorno profesional Alibaba Cloud asegura que no usa los datos para entrenamiento y que cifra la información con AES-256. También explica que el tratamiento de las conversaciones cambia según el tipo de uso: en llamadas directas por API no se guardan, mientras que en otros modos sí puede conservarse historial para mejorar la experiencia. Google introduce un matiz comparable: con Gemini API de pago, los prompts y respuestas no se usan para entrenar modelos y se tratan como confidenciales. A ese marco debemos señalar otro elemento de contexto: la Ley de Inteligencia Nacional china, en su artículo 7, establece que organizaciones y ciudadanos deben, conforme a la ley, “apoyar, asistir y cooperar” con el trabajo de inteligencia nacional, manteniendo además el secreto sobre lo conocido, una obligación legal que ha generado preocupaciones en la Unión Europea y en otras partes del mundo.

Imágenes | Xataka con Gemini 3 Pro | Captura de pantalla

En Xataka | La cantidad de nuevas aplicaciones que llegan a la App Store se ha disparado. Tenemos un culpable: el "vibe coding"


via Robótica e IA - Xataka https://ift.tt/TSdk3e5

La cantidad de nuevas aplicaciones que llegan a la App Store se ha disparado. Tenemos un culpable: el "vibe coding"

La cantidad de nuevas aplicaciones que llegan a la App Store se ha disparado. Tenemos un culpable: el "vibe coding"

La llegada de herramientas basadas en inteligencia artificial generativa ha provocado una auténtica explosión en las tiendas de aplicaciones móviles, sobre todo desde que contamos con entornos de desarrollo con IA que nos permiten crear y desplegar aplicaciones sin necesidad de saber de programación.

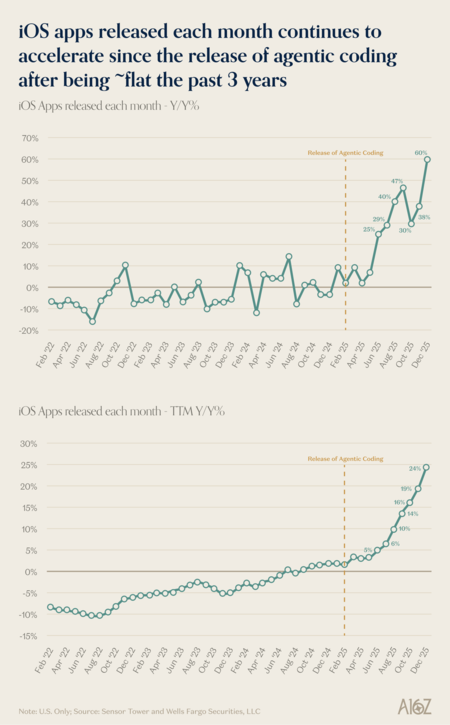
Según datos del fondo de capital de riesgo Andreessen Horowitz (a16z), las nuevas apps lanzadas en la App Store de iOS en Estados Unidos aumentaron un 60% interanual en diciembre, tras permanecer prácticamente estancadas durante los tres años anteriores. El crecimiento interanual acumulado en los últimos doce meses alcanza el 24%. El responsable tiene nombre: el "vibe coding", esa manera de programar en la que la IA hace gran parte del trabajo.

Lo que está pasando. 2025 ha sido el año en el que la “programación por sensaciones” ha explotado. Y es que en entornos de ‘programación agéntica’ o de vibe coding, basta con explicarle a una herramienta de IA qué aplicación necesitas y la máquina se encarga de escribir el código. Plataformas como Cursor, Bolt, Google AI Studio, Claude Code o V0 han democratizado la creación de apps hasta el punto de que cualquier persona con una idea puede convertirla en un prototipo funcional sin escribir una sola línea de código.

Esto abre muchas puertas, ya que miles de nuevos desarrolladores sin formación técnica están publicando aplicaciones en las tiendas. Eso también es un problema.

Volviendo a 2008. Como señala a16z, la situación evoca los primeros días del iPhone, cuando Apple lanzó su SDK y en cuestión de meses pasó de 500 aplicaciones a descargas que superaban los 1.000 millones. Aquel ecosistema acabó generando cientos de miles de millones de dólares en ingresos. Aquí el fenómeno es aún más apabullante, ya que la creación de aplicaciones deja de estar ‘limitada’ a desarrolladores con experiencia, lo que hace que en una tarde podamos crear cualquier app sencilla, siempre y cuando sepamos qué pedirle a la IA.

Grafica Crecimiento Apps Con Ia Grafica Crecimiento Apps Con Ia Imagen: a16z

El problema. Las cosas claras: en una frase no vas a poder crear una compleja aplicación. Y ya nos lo decía Miguel Ángel Durán, ingeniero de software conocido como midudev, en marzo del año pasado: "no te pienses que con decirle algo sin saber nada de programación te va a dar el próximo Airbnb". 

Tal y como mencionaba mi compañero Javier Pastor hace un tiempo, el caso de Leo, un usuario que creó una plataforma SaaS completa con vibe coding y consiguió incluso clientes de pago, ilustra perfectamente los riesgos, ya que dos días después de presumir de su logro, tuvo que pedir ayuda porque su app mostraba claves públicas de API, tenía un muro de pago fácil de saltarse y colapsaba su base de datos por errores básicos de programación.

La calidad importa. "Se pueden hacer cosas muy básicas. Nosotros hemos probado Cursor, Bolt, etc., y se llega a un nivel que uno puede pensar que es avanzado, pero en realidad lo que suele pasar es que están clonando un repositorio de Github y cambiándole los colores", nos contaba hace un tiempo Daniel Ávila, cofundador de CodeGPT.

Existe una inundación de aplicaciones de baja calidad, mucho más que antes, dado que ahora mucha más gente sin experiencia puede publicarlas fácilmente en cualquier tienda de aplicaciones. Y el problema está en que muchas de estas aplicaciones no llegan ni al nivel de prototipo, siendo productos sin terminar que funcionan superficialmente y que luego acaban acumulando todo tipo de errores técnicos. Peor aún si la app cuenta con un muro de pago.

Entre el optimismo y cautela. "El vibe coding es súper interesante para extender el prototipado de ideas y empoderar a la gente", nos explicaba el año pasado Nerea Luis, doctora en ciencias de la computación. Pero también reconoce que "tiene riesgos" porque completar estos proyectos requiere conocimientos que ni el usuario ni la IA poseen. Por otra parte, Omar Pera, Chief Product Officer de Freepik, era más optimista: "a los ingenieros top el vibe coding les convierte en ingenieros 2x o 3x".

¿Democratiza el acceso al desarrollo de aplicaciones? Sí, desde luego. El problema viene cuando la aplicación generada por IA de alguien sin experiencia pasa de un proyecto para aprender, como pasatiempo, o como desarrollo de app para uso propio, a un proyecto que abarque más ambición y que busque captar muchos clientes.

Imagen de portada | James Yarema

En Xataka | Creíamos que la guerra de talento de la IA es sobre de ingenieros y desarrolladores. En realidad, va de fontaneros y electricistas


via Robótica e IA - Xataka https://ift.tt/lkdmcNW

Hay una startup china creando los robots más alucinantes del momento. Se llama X Square

Hay una startup china creando los robots más alucinantes del momento. Se llama X Square

La única empresa de embodied AI (inteligencia artificial con cuerpo) con respaldo de los tres gigantes tecnológicos chinos: ByteDance, Meituan y Alibaba. Poco más de dos años de vida y rondas de financiación en las que han logrado superar los 400 millones de dólares. Estas son algunas de las cartas de presentación de X Square Robot, una de las empresas más prometedoras en el campo de la robótica.

De dónde viene. X Square es una startup china que nace en 2023 a manos de Wang Qian, ingeniero y doctor por la Universidad del Sur de California que, durante los últimos años, ha mantenido un perfil discreto en la industria. La empresa nace no solo como una empresa orientada a la creación de robots humanoides: están también detrás de la parte del desarrollo de los modelos de lenguaje necesarios para liderar en robótica.

La hoja de ruta. La startup, a pesar de su juventud, ha exprimido al máximo sus dos años de vida.

  • Diciembre de 2023, financiación completa e inicio de operaciones.
  • Marzo de 2024, comienzan los esfuerzos para desarrollar un modelo general a gran escala para embodied AI, el cerebro que movería a sus robots.
  • Mayo de 2025, comercialización de Quanta X1, un robot bimanual con ruedas equipado con su modelo WALL-A. Especialmente pensado para tareas de logística y comerciales.
  • Julio de 2025, primera en mostrar un modelo de IA de propósito general capaz de controlar directamente una mano robótica de alta destreza A diferencia de enfoques tradicionales —basados en reglas, trayectorias fijas o entrenamiento específico por acción— el sistema utiliza un único modelo que integra percepción, planificación y control, permitiendo adaptar el agarre y el movimiento en tiempo real ante variaciones del entorno.
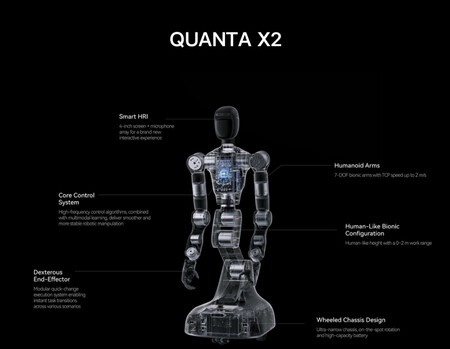
  • Agosto de 2025, llega Quanta X2, su primer robot humanoide, también con base de ruedas. 
Captura De Pantalla 26 01 2026 A 12 04 20 P M Captura De Pantalla 26 01 2026 A 12 04 20 P M

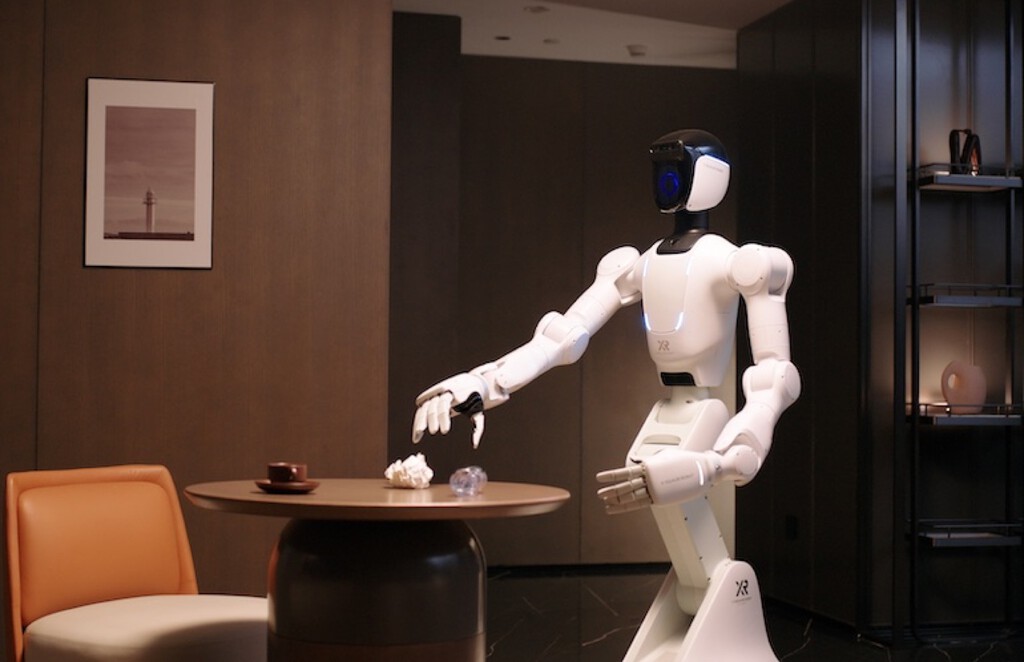
El producto. Quanta X2 es la última solución de X Quare, un robot humanoide con ruedas que integra el modelo propio de IA de la compañía. Este modelo permite al robot contar con un sistema de visión, control de movimiento autónomo, planificación de tareas en tiempo real, etc. Te recomendamos encarecidamente ver el vídeo de demostración en el que X Square lo muestra en funcionamiento, porque es espectacular.

Por qué es importante. X Square no vende robots humanoides al uso, vende capacidad cognitiva. La norma en empresas de robótica es diseñar el hardware y adaptarlo a software existente. X Square diseña sus propios modelos centrados en IA física. Esto es algo fundamental para su país natal, China.

  • El país quiere acelerar la industria automovilística en 2030 con fábricas 100% automatizadas.
  • La política de ayudas es especialmente favorable para empresas locales desarrollando soluciones de robótica.
  • China ha creado centros encargados de entrenar a robots para que imiten el comportamiento humano. El software de X Square es clave

El respaldo. X Square cuenta con el respaldo de gigantes como Alibaba y Bytedance, habiendo anunciado el primer grupo un equipo interno dedicado a la robótica utilizando como base Qwen, su división de modelos de IA. Pese al músculo de Alibaba a la hora de crear sus propios modelos de lenguaje, la inversión de más de 140 millones de dólares en X Square Robot deja claro que es mucho más que una startup al uso. 

Imagen | X Square

En Xataka | La robótica acaba de romper otra barrera de escala: ya hay robots autónomos más pequeños que un grano de sal


via Robótica e IA - Xataka https://ift.tt/2JkLd94

Sandisk ha subido un 1.000% en bolsa desde verano. Su ventaja se llama Kioxia

Sandisk ha subido un 1.000% en bolsa desde verano. Su ventaja se llama Kioxia

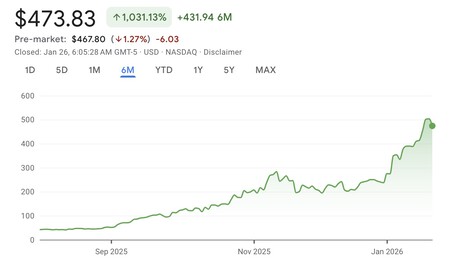
En apenas cinco meses las acciones de Sandisk se han disparado un 1.000% en una de las recuperaciones más asombrosas de la historia de Wall Street. La empresa ha sido la última gran beneficiada del auge de la IA y de esa fiebre por construir centros de datos llenos de chips avanzados de IA... y también de las memorias que acompañan a esos chips. Ahí es donde entra la gran baza de Sandisk, llamada Kioxia.

Captura De Pantalla 2026 01 26 A Las 12 13 48 Captura De Pantalla 2026 01 26 A Las 12 13 48 Valor de las acciones de Sandisk en los últimos seis meses. Fuente: Google Finance.

Sin saberlo, SanDisk estaba lista para la revolución. Las memorias HBM eran tradicionalmente las favoritas para acompañar a las GPUs que eran el gran "cerebro" de la IA, pero la escasez de estos componentes con alto ancho de banda ha hecho que el protagonismo se centre desde hace unos meses en las memorias DRAM y NAND, dos tipos de almacenamiento en los que sanDisk es un actor dominante. Como otros fabricantes de su segmento —Micron es uno de los destacados—, SanDisk se ha encontrado de buenas a primera con una situación que la beneficiaba enormemente.

Dinero gratis. El mercado de los chips de memoria funciona como un mercado de materias primas en el que el apalancamiento puede llegar a ser notable. Eso significa que cuando los precios suben, empresas como SanDisk no necesitan invertir en nuevas fábricas o empleados para ganar más —aunque pueden construirlas si lo consideran necesario—. Es como si para Micron o SanDisk este fenómeno equivaliese a "dinero gratis"m porque están recibiendo muchísimos más ingresos por los mismos productos que vendían hace uno o dos años. Ni siquiera ellos mismos se lo esperaban: el CEO de SanDisk, David Goeckeler, habló del auge de la IA en junio, y comentó que "tratamos de estimar la demanda. Pensamos que la demanda es buena. Lo que necesitamos es lograr que la oferta se corresponda con eso". No pudo anticipar lo que ocurriría con las memorias a partir de septiembre.

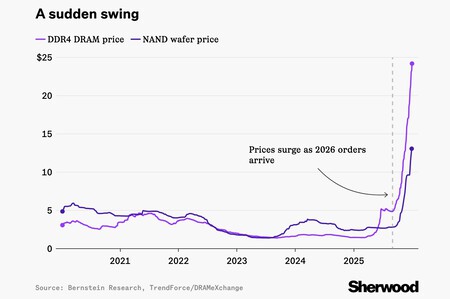
Captura De Pantalla 2026 01 26 A Las 12 10 55 Captura De Pantalla 2026 01 26 A Las 12 10 55 Los precios de las memorias DRAM y NAND están disparándose desde finales de 2025. Fuente: Sherwood.

La alianza clave: Kioxia. En los últimos tiempos SanDisk ha crecido de forma significativa en su negocio de unidades de estado sólido (SSD) para centros de datos empresariales. Pero es que además mantiene una alianza estratégica histórica con la empresa japonesa Kioxia, lo que la permite obtener chips NAND a un coste mucho menor al de sus rivales. El margen de beneficio se dispara, y las acciones en bolsa, también.

Una relación con altibajos. La relación entre Sandisk y Kioxia (antiguamente Toshiba Memory) se basa en una Joint Venture de hace más de 20 años centrada en el desarrollo de memorias NAND. Esa alianza ha logrado avances como las memorias BICS Flash (con tecnología de almacenamiento 3D), las obleas que salen de sus fábricas son compartidas entre ambas empresas. Kioxia pasó una etapa difícil tras la crisis financiera de Toshiba y los intentos fallidos de fusión con Western Digital. Sobrevivieron a todo ello, y junto a Sandisk ahora la empresa nipona controla el 30% del mercado mundial de NAND.

Unos ganan, otros pierden. El fondo de inversión Elliot Management presionó a principios de 2025 para que SanDisk se separara de Western Digital. Creyeron que por entonces valía unos 20.000 millones de dólares —como cuando la compró hace una década—, y ese fondo vendió su participación justo antes de la explosión total del mercado. Hoy esa participación valdría más de 340 millones de dólares.

Mal asunto para los usuarios. Pero además de ese fondo, los que lo tenemos más complicado somos los usuarios, que seguiremos sufriendo las consecuencias de este fenómeno durante meses, y quizás años. Ni Micron ni Sandisk/Kioxia parecen tener intención alguna de ampliar la capacidad de producción de forma notable. Ya lo hicieron durante la pandemia y eso provocó un exceso de inventario cuando la demanda cayó tras el confinamiento. Ahora no quieren exponerse a lo mismo, y se habla de que la subida de precios se mantendrá durante todo 2026 y puede que tardemos bastante en ver memorias a precios "como los de antes"... si es que acabamos viéndolos.

Imagen | Igor Shalyminov

En Xataka | Japón ha sacado el talonario para volver a dominar la industria de los chips. Prepara un plan de 325.000 millones de dólares


via Robótica e IA - Xataka https://ift.tt/hUfkGxo